中国农业大学生物学院张子丁课题组在《Briefings in Bioinformatics》发表人-病毒蛋白互作计算研究综述
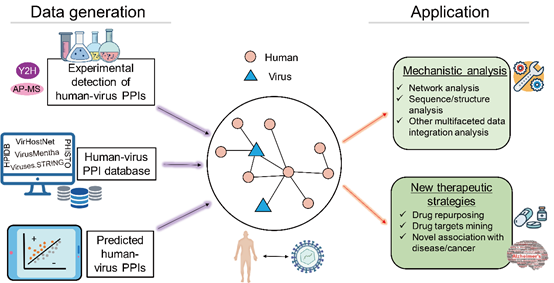
中国农业大学生物学院张子丁课题组在国际知名生物信息学期刊《Briefings in Bioinformatics》上发表题为“Computational studies on human-virus protein-protein interactions: current status and future perspectives”的综述论文。该研究系统梳理了人-病毒蛋白互作(human-virus protein-protein interactions, hvPPIs)计算研究领域的发展历程、主流方法、现存挑战及未来发展方向,为深入理解病毒感染机制和抗病毒药物研发提供了重要的理论参考。
人-病毒蛋白互作是病毒感染宿主并引发疾病的关键环节。病毒通过其编码蛋白与人体宿主蛋白发生物理相互作用,进而劫持或干扰宿主细胞正常生理过程,实现复制与传播。因此,系统解析hvPPIs对于揭示病毒致病机理、发现抗病毒药物靶点以及开发新型疫苗和广谱抗病毒策略均具有重要意义。传统生物学实验方法在鉴定hvPPIs时通常耗时、昂贵且难以覆盖全部可能的病毒-宿主蛋白组合,尤其面对新发突发病毒时更显局限。在此背景下,计算生物学方法已成为补充和加速hvPPIs研究不可或缺的手段。
论文首先回顾了人-病毒蛋白互作计算研究的数据资源积累情况,梳理了包括P-HIPSTer、VirHostNet、IntAct等公开数据库中病毒-宿主互作数据的规模与特点。综述重点了目前主流的计算预测方法,涵盖基于序列特征、结构信息、网络拓扑以及机器学习(尤其是深度学习)等多个技术路线。论文指出,早期研究多依赖蛋白序列保守性、氨基酸理化性质及结构域信息进行特征编码,结合支持向量机、随机森林等传统机器学习模型进行预测。随着AlphaFold等结构预测技术的突破以及图神经网络、Transformer等深度学习框架的引入,hvPPIs预测的精度和泛化能力得到显著提升。部分研究开始尝试整合多组学数据,如转录组、蛋白质组及临床表型数据,以从系统层面刻画病毒-宿主互作网络。
针对该领域面临的核心挑战,论文进行了深入分析。其一,数据不平衡和偏差问题突出——已知正样本(确认互作)数量有限,而负样本定义模糊且难以验证,导致训练集构建困难。其二,病毒蛋白与宿主蛋白序列特征差异显著,跨物种预测时模型迁移能力受限。其三,多数计算预测缺乏高置信度的实验验证,假阳性率较高。其四,对于新发病毒或突变迅速出现的病毒变体,基于已知近缘病毒数据训练的模型往往泛化性能不足,难以满足快速应对疫情的需求。其五,病毒蛋白常与宿主蛋白发生多界面、多构象的相互作用,现有方法仍未充分捕捉互作动态性与变构效应。
面向论文提出了若干前沿发展方向。第一,发展面向“零样本”或“少样本”场景的预测算法,结合元学习、自监督预训练等技术增强对新病毒或未表征病毒的预测扩展能力。第二,融合更接近生理条件的结构与计算模拟(如分子动力学、冷冻电镜动态构象)、单细胞多组学数据以及跨尺度网络模型,提升互作预测的生物学辨识度。第三,通过主动学习闭环,优先筛选高信息量的候选互作进行实验验证,借助高通量酵母双杂交、蛋白质片段互补等方法提升数据质量,缓解数据偏差。第四,建立标准化的基准数据集、统一的评估指标以及可解释性框架,促进方法之间的横向比较与临床靶点转化。第五,将hvPPIs预测更紧密应用于抗病毒药物重定位和广谱抗病毒抑制剂设计,加速基础研究向防控应用的转化。
通讯作者张子丁教授长期致力于蛋白质-蛋白质相互作用的计算研究及生物分子网络分析,在相关领域发表了一系列具有国际影响力的成果。该综述得到了国家自然科学基金等项目的资助,并获得了国内外同行的高度关注。论文的合作者包括课题组博士研究生和相关院校研究人员。通过系统规划计算hvPPIs研究的现有框架与优先突破点,该综述有望推动生物信息学、病毒学及药物设计学科的交叉融合,为因应未来重大病毒性传染病威胁提供方法学支撑。
据悉,《Briefings in Bioinformatics》是生物信息学领域最具权威性的综述类期刊之一,最新影响因子超过13,具有广泛的学术影响力。张子丁课题组此次受邀发表综述论文,反映出中国农业大学生物学院在计算生物学与病原-宿主互作领域的国际学术影响持续提升,也为后续开展更深入的国际合作与协同创新奠定了良好基础。
如若转载,请注明出处:http://www.daxuejulebu.com/product/51.html
更新时间:2026-10-22 15:05:43